Проверка индексации отвечает на простой вопрос: может ли поисковый робот открыть нужную страницу, понять её содержание и добавить URL в свою базу. Сам факт, что адрес открывается в браузере, ещё не означает, что он доступен для поиска. На результат влияют HTTP-статус, robots.txt, meta robots, canonical, качество страницы и внутренние ссылки.
Проверять сайт удобнее слоями. Сначала смотрят общий список важных URL, затем доступ робота и технические ответы, после этого — отчёты Google Search Console и Яндекс Вебмастера. Такой порядок помогает не путать отсутствие обхода с исключением страницы из индекса.
Составьте список страниц для проверки
Начните не с случайной страницы, а с карты приоритетов. В список включите главную, разделы, карточки услуг или товаров, свежие публикации и URL, на которые ведёт реклама. Отметьте дату создания, канонический адрес и ожидаемый тип страницы. Если URL дублируется с параметрами, сразу укажите, какая версия считается основной.
Для небольшого сайта подойдёт таблица, где у каждой строки есть URL, HTTP-статус, директива robots, наличие в sitemap и результат проверки в панели вебмастера. На большом проекте список можно выгрузить из CMS или краулера, но ручная выборка важных страниц всё равно нужна: автоматический отчёт не знает, какие URL действительно ценны для бизнеса.
Проверьте HTTP-ответ и редиректы
Рабочая контентная страница обычно отдаёт 200. Перенесённый URL должен вести на актуальный адрес через постоянный редирект, а удалённый материал — возвращать подходящий статус или понятную замену. Цепочка из нескольких редиректов замедляет обход и усложняет диагностику. Запишите конечный адрес и сравните его с canonical.
Ответ 200 не гарантирует индексацию: страница может содержать noindex, быть почти пустой или считаться дублем. И наоборот, блокировка в robots.txt не всегда удаляет уже известный URL из поисковой базы, потому что робот не может прочитать содержимое. Поэтому статус сервера проверяют вместе с HTML и настройками индексации.
| Сигнал | Что проверить | Частая ошибка |
|---|---|---|
| HTTP | 200, 3xx, 4xx или 5xx | Считать любой 200 проиндексированным |
| robots.txt | Нет ли Disallow для нужного пути | Закрыть весь раздел одной строкой |
| meta robots | Нет ли noindex на важной странице | Оставить директиву в шаблоне |
| canonical | Указывает на правильную версию | Сослаться на другой раздел или 404 |
| Sitemap | URL существует и отдаёт 200 | Добавлять туда редиректы и дубли |
Разберите robots.txt и sitemap
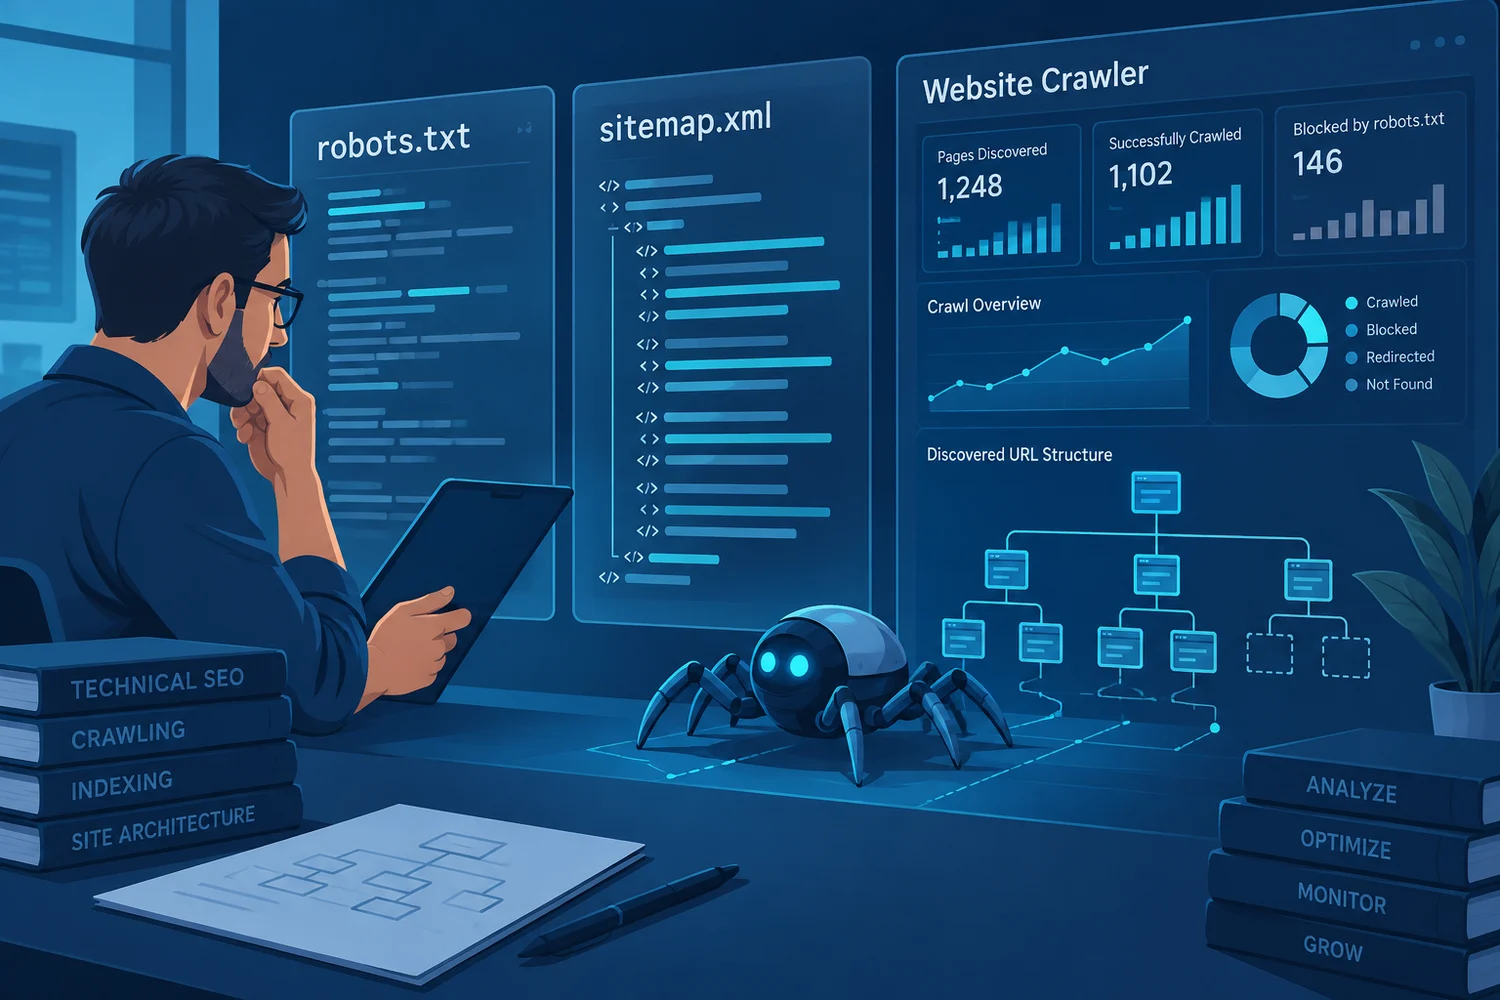
Файл robots.txt задаёт правила обхода, но не заменяет управление индексацией. Найдите блоки User-agent и проверьте, не закрыты ли важные каталоги, CSS, JavaScript или изображения. Синтаксис зависит от робота, поэтому после изменения полезно использовать встроенный анализатор конкретной панели.
Sitemap должен содержать канонические URL, которые действительно должны участвовать в поиске. Уберите из карты страницы с noindex, редиректы, дубли и ответы с ошибками. Если карта разделена на несколько файлов, проверьте индекс sitemap и даты обновления. После публикации новой страницы добавьте её в карту автоматически через CMS, а не вручную в случайный файл.
- Скачайте robots.txt по адресу сайта и сохраните копию.
- Проверьте важные пути с тестовым инструментом панели вебмастера.
- Откройте sitemap и убедитесь, что URL написаны в канонической форме.
- Удалите из карты страницы с редиректом, ошибкой и noindex.
- После правки отправьте карту на повторную обработку.
Проверьте noindex, canonical и заголовки
В исходном HTML найдите атрибут meta name «robots» и заголовок X-Robots-Tag. Директива noindex уместна для служебных страниц, фильтров и временных результатов, но случайно попавшая в шаблон запрещает видимость всего раздела. Проверяйте не только код ответа, но и HTML, который получает робот.
Canonical сообщает предпочтительную версию среди похожих URL. Он не принуждает поисковик индексировать страницу, если содержимое слабое или адрес закрыт. Ссылка должна быть абсолютной или корректно разрешаться относительно домена, не вести на другой язык, протокол или старый slug. На странице с уникальным материалом canonical обычно указывает на неё саму.
Полезно сверить структуру заголовков и основной текст. Если важный контент появляется только после клика или загружается скриптом с ошибкой, робот может увидеть неполную страницу. Ссылки должны быть обычными HTML-ссылками с понятным анкором, чтобы поисковик мог перейти к связанным материалам.
В разделе об поисковом интенте показано, почему формат страницы должен соответствовать задаче пользователя. А метрики из материала о ключевых SEO-показателях помогают понять, какие URL проверять в первую очередь.
Используйте Google Search Console
В URL Inspection можно проверить конкретный адрес, увидеть последнее сканирование, канонический URL и причины исключения. Запрос на индексацию уместен после существенного обновления, но не гарантирует мгновенное добавление страницы. Если URL заблокирован robots.txt или содержит noindex, сначала исправьте причину.
Отчёт Page indexing показывает группы исключённых URL. Читайте пример, а не только количество: «обнаружена, но не проиндексирована» требует оценки качества и внутренних ссылок, «просканирована, но не проиндексирована» — проверки полезности и дублей, а ошибка сервера — работы с доступностью. После исправления запускайте проверку только для подтверждения конкретного изменения.
Используйте Яндекс Вебмастер
В Яндекс Вебмастере есть инструменты проверки robots.txt, отправки sitemap и мониторинга важных страниц. Сначала убедитесь, что добавлена правильная версия сайта с протоколом и зеркалом. Затем сопоставьте отчёт об обходе с собственной таблицей URL: если робот посещает служебные параметры, а нужный раздел не трогает, ищите лишние ссылки или ограничение в правилах.
Не отправляйте на переобход сотни страниц без причины. Разделите изменения на группы и фиксируйте дату, чтобы понимать, какой шаг дал эффект. Если страница доступна, но долго не появляется в поиске, проверьте уникальность, внутренние ссылки и соответствие намерению пользователя, а не только кнопку переобхода.

Как найти причину исключения
Соберите цепочку: URL → ответ сервера → доступ робота → директивы → canonical → содержание → внутренние ссылки → отчёт панели. На каждом шаге фиксируйте наблюдение и действие. Например, если HTML отдаёт 200, robots разрешает обход, но URL признан дублем, найдите основную версию и добавьте полезную уникальность, а не меняйте случайно мета-теги.
После исправления очистите кэш, если он может отдавать старый HTML, и проверьте страницу с внешней сетью. Убедитесь, что заголовки одинаковы для обычного браузера и робота, а нужные изображения и скрипты не блокируются. Затем повторите URL Inspection и запишите дату проверки в рабочую таблицу.
Чек-лист перед публикацией
- URL входит в список страниц, которые действительно должны находиться в поиске.
- Страница отдаёт ожидаемый HTTP-статус и не содержит лишней цепочки редиректов.
- robots.txt не закрывает путь, а sitemap содержит канонический адрес.
- noindex отсутствует, если страница должна индексироваться.
- canonical совпадает с выбранной версией URL.
- На страницу ведут внутренние ссылки, а контент доступен в HTML.
- Проверка в Google и Яндексе сохранена с датой и результатом.
Индексация — это результат согласованной работы технических сигналов и полезного содержания. Проверяйте их в одном порядке, не делайте вывод по одному отчёту и сохраняйте историю изменений. Тогда проблема перестаёт быть загадочным «почему страницы нет» и превращается в последовательную задачу с проверяемыми шагами.